Один день без серверів: у що це обійдеться бізнесу.
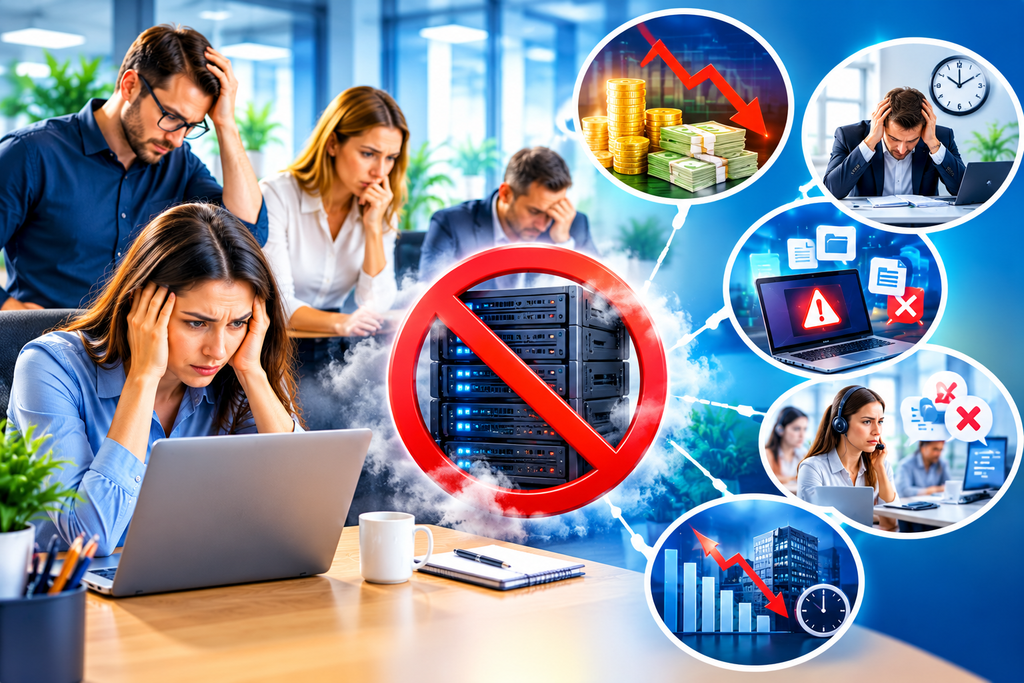
Уявімо звичайний робочий день. Співробітники приходять до офісу, відкривають комп’ютери, запускають корпоративні програми – і раптом нічого не працює.
Недоступні спільні файли. Не відкривається бухгалтерська система. CRM не відповідає. Не працює внутрішня база даних, а частина співробітників не може отримати доступ до потрібних документів.
Причина може бути в одному сервері, від якого залежать десятки робочих місць.
На перший погляд здається, що потрібно лише відновити роботу обладнання. Але для бізнесу проблема значно ширша: кожна година простою може означати втрачений робочий час, затримки перед клієнтами, додаткові витрати та невиконані зобов’язання.
Вартість серверного простою – це не лише рахунок за ремонт. Це сукупність прямих, непрямих і потенційних фінансових втрат компанії.
1. Що зупиняється разом із сервером?
У сучасній компанії сервери можуть забезпечувати роботу багатьох критичних систем:
– файлового сховища та спільних документів;
– бухгалтерських програм і баз даних;
– CRM та систем управління бізнес-процесами;
– корпоративної пошти й внутрішніх сервісів;
– віртуальних машин;
– систем резервного копіювання;
– служб ідентифікації та доступу;
– окремих сервісів для клієнтів і партнерів.
Важливо розуміти: не кожна несправність сервера зупиняє весь бізнес. Наслідки залежать від архітектури інфраструктури, наявності резервних систем і того, які процеси прив’язані до конкретного обладнання.
Проте якщо один сервер обслуговує кілька важливих систем, його відмова може вплинути одразу на багато підрозділів.
Чим більше бізнес-процесів залежать від одного компонента, тим важливіше заздалегідь передбачити резервування та план відновлення.
2. Втрата робочого часу співробітників.
Одна з найбільш очевидних втрат – час, протягом якого працівники не можуть виконувати свої завдання.
Наприклад, менеджер не має доступу до CRM, бухгалтер не може працювати з базою даних, а відділ продажів не може отримати актуальні документи.
Зарплатні витрати при цьому продовжують виникати, навіть якщо продуктивність тимчасово знизилася.
Для орієнтовної оцінки можна використати просту формулу:
Втрати робочого часу = кількість працівників × тривалість простою × середня вартість робочої години.
Припустімо, 20 співробітників не можуть повноцінно працювати протягом 8 годин, а умовна вартість години роботи одного працівника для компанії становить 250 грн.
Розрахунок: 20 × 8 × 250 = 40 000 грн.
Це лише умовна оцінка вартості втраченого робочого часу, а не повна сума збитків. Вона не враховує відкладені продажі, пропущені строки, оплату аварійних робіт та інші наслідки.
Крім того, не всі співробітники обов’язково простоюватимуть увесь час. Частина може перейти до інших завдань, а частина процесів – продовжити роботу.
Саме тому для реальної оцінки потрібно аналізувати конкретну діяльність компанії.
3. Відкладені продажі та невиконані зобов’язання.
Якщо сервер підтримує роботу CRM, замовлень, складу або клієнтського сервісу, його недоступність може впливати безпосередньо на дохід.
Наприклад:
– менеджери не можуть обробити нові замовлення;
– склад не отримує актуальних даних;
– клієнти не отримують відповіді вчасно;
– затримується підготовка документів;
– не виконуються заплановані відвантаження;
– виникають затримки у взаєморозрахунках.
Частина цих операцій може бути виконана пізніше, але перенесення роботи не завжди означає відсутність збитків.
Компанія може втратити замовлення, порушити договірні строки або витратити додатковий час на відновлення процесів.
Тут важливо відрізняти втрачений дохід від відкладеного доходу. Не кожне замовлення, яке не оформлено під час простою, буде втрачено остаточно. Але для критичних процесів навіть тимчасова недоступність може мати відчутні наслідки.
4. Аварійне відновлення коштує дорожче за планове обслуговування.
Коли сервер виходить з ладу в робочий час, компанія часто змушена діяти терміново.
Можуть знадобитися:
– аварійна діагностика;
– терміновий виїзд IT-фахівця;
– закупівля комплектуючих;
– перенесення систем на інше обладнання;
– відновлення операційної системи;
– відновлення баз даних і конфігурацій;
– перевірка працездатності залежних сервісів.
Усе це може коштувати дорожче, ніж планова заміна застарілого компонента або регулярне профілактичне обслуговування.
Особливо складною є ситуація, коли обладнання вже не підтримується виробником або необхідні запасні частини важко знайти.
Планування технічного обслуговування дозволяє виконувати частину робіт у зручний час, а не під тиском аварійної ситуації.
5. Резервна копія не означає миттєве відновлення.
Поширена помилка – вважати, що за наявності резервної копії сервер можна швидко повернути до роботи.
Насправді backup допомагає відновити дані, але не обов’язково одразу відновлює весь сервіс.
Потрібно врахувати:
– час на підготовку обладнання;
– встановлення або відновлення системного середовища;
– відновлення даних;
– налаштування мережевих підключень;
– перевірку баз даних;
– запуск залежних програм;
– тестування працездатності;
– повернення доступу користувачам.
Для однієї системи відновлення може бути відносно простим. Для іншої – вимагати послідовного запуску кількох взаємозалежних компонентів.
Тому важливо перевіряти не лише факт створення резервних копій, а й реальний час відновлення критичних сервісів.
6. Приховані наслідки простою.
Фінансові втрати не обмежуються ремонтом і робочим часом.
Серед додаткових наслідків можуть бути:
6.1. Понаднормова робота. Співробітникам доводиться надолужувати завдання після відновлення систем.
6.2. Затримки обслуговування клієнтів. Навіть якщо сервер запрацював, накопичені звернення та замовлення можуть потребувати додаткового часу.
6.3. Порушення внутрішніх процесів. Відділи, які залежать від спільних даних, можуть не мати змоги продовжити роботу без актуальної інформації.
6.4. Репутаційні ризики. Повторювані проблеми з доступністю сервісів можуть знижувати довіру клієнтів і партнерів.
6.5. Додаткове навантаження на IT-команду. Замість планових завдань фахівці займаються аварійним відновленням.
Не всі ці наслідки обов’язково виникають у кожному випадку. Але їх варто враховувати під час оцінювання ризиків і планування захисту інфраструктури.
7. Як приблизно розрахувати вартість одного дня простою?
Для оцінювання ризиків бізнес може використовувати власну модель.
До розрахунку варто включити:
– вартість робочого часу співробітників, які не можуть виконувати свої завдання;
– прямі витрати на діагностику, ремонт і аварійні роботи;
– додаткові витрати на відновлення даних і сервісів;
– втрати від замовлень, які не вдалося виконати;
– витрати на надолуження роботи після відновлення;
– інші наслідки, характерні для конкретної галузі.
Важливо уникати подвійного врахування одних і тих самих втрат. Наприклад, якщо вартість невиконаного замовлення вже врахована як втрачений прибуток, її не слід ще раз додавати як повністю втрачену виручку без відповідного обґрунтування.
Наведена нижче модель допоможе сформувати початкову оцінку.
Стаття витрат:
– простій працівників;
– аварійні роботи;
– відновлення;
– втрачені можливості;
– надолуження роботи.
Що врахувати:
– вартість втраченого робочого часу;
– діагностика, ремонт, термінова закупівля;
– час і ресурси на повернення систем до роботи;
– втрачений прибуток від невиконаних замовлень;
– додаткові години та організаційні витрати.
Результат буде набагато точнішим, якщо розрахунок ґрунтуватиметься на реальних даних компанії, а не на універсальних середніх показниках.
8. Як зменшити ризик серверного простою?
Повністю виключити технічні збої неможливо. Але можна зменшити ймовірність деяких інцидентів, обмежити їхні наслідки та скоротити час відновлення.
Для цього варто організувати кілька рівнів захисту.
8.1. Моніторинг серверів.
Контролюйте завантаження процесора, оперативну пам’ять, стан дисків, вільне місце та доступність критичних сервісів.
Раннє виявлення відхилень допомагає звернути увагу на проблему до того, як вона переросте в аварію.
8.2. Планове обслуговування.
Регулярно перевіряйте стан обладнання, актуальність програмного забезпечення, резервні компоненти та конфігурації систем.
8.3. Резервне копіювання.
Створюйте копії критичних даних, захищайте їх від несанкціонованого доступу та регулярно перевіряйте можливість відновлення.
8.4. Резервування критичних компонентів.
Для важливих сервісів доцільно оцінити потребу в резервному обладнанні, альтернативних мережевих з’єднаннях або інших механізмах відмовостійкості.
Конкретна архітектура залежить від критичності сервісу, допустимого часу простою та бюджету.
8.5. План аварійного відновлення.
Визначте, хто відповідає за реагування, які системи потрібно відновлювати першими та які дії необхідні для повернення бізнес-процесів до нормальної роботи.
9. Важливо знати RTO та RPO.
Для критичних систем варто заздалегідь визначити два показники.
9.1. RTO (Recovery Time Objective) – цільовий час відновлення сервісу після збою.
9.2. RPO (Recovery Point Objective) – допустимий період втрати даних, який визначає, до якого моменту інформація має бути доступною після відновлення.
Наприклад, для однієї системи компанія може погодитися на відновлення протягом робочого дня, а для іншої потрібне значно швидше повернення до роботи.
Ці цілі допомагають визначити, чи достатньо звичайного резервного копіювання, чи потрібні додаткові механізми резервування та відновлення.
Важливо також перевіряти, чи досягаються ці показники на практиці, а не лише зафіксовані в документації.
10. Не кожному бізнесу потрібна дорога відмовостійка система.
Захист серверної інфраструктури має відповідати реальним ризикам.
Для невеликої компанії з некритичними внутрішніми сервісами може бути достатньо якісного резервного копіювання, моніторингу та зрозумілого плану відновлення.
Для бізнесу, який обробляє замовлення безперервно або залежить від доступності систем протягом усього дня, можуть знадобитися резервні сервери, реплікація даних та інші механізми відмовостійкості.
Тому правильний підхід – не купувати найдорожче обладнання, а визначити:
– які системи критичні;
– скільки часу вони можуть бути недоступними;
– який обсяг даних допустимо втратити;
– скільки коштує простій;
– які заходи забезпечать прийнятний рівень надійності.
11. Що отримує бізнес від завчасної підготовки?
Професійно організована серверна інфраструктура допомагає:
– зменшувати ризик тривалих простоїв;
– швидше виявляти несправності;
– планувати технічне обслуговування;
– контролювати стан резервних копій;
– скорочувати час відновлення;
– прогнозувати витрати на IT;
– забезпечувати стабільнішу роботу співробітників і сервісів.
І головне – компанія отримує можливість реагувати на технічні проблеми за підготовленим планом, а не починати пошук рішень у момент аварії.
Один день без серверів може коштувати бізнесу значно більше, ніж ремонт обладнання.
Наслідки залежать від того, які процеси зупинилися, скільки співробітників втратили можливість працювати, чи постраждали клієнтські операції та скільки часу потрібно для відновлення.
Саме тому важливо не лише підтримувати сервери в робочому стані, а й розуміти, які втрати може спричинити простій і що потрібно зробити, щоб їх мінімізувати.
Моніторинг, планове обслуговування, захищене резервне копіювання та перевірений план відновлення допомагають підготуватися до збоїв і зменшити їхні наслідки.
Надійна IT-інфраструктура – це не гарантія того, що збоїв ніколи не буде. Це готовність бізнесу швидко та організовано відновити роботу, якщо проблема все ж виникне.
Якщо ваша компанія залежить від серверів, варто почати з аудиту критичних систем, оцінювання можливих втрат і перевірки готовності до відновлення. Це допоможе визначити найважливіші ризики та обґрунтовано спланувати заходи захисту.
Інші записи:
- Коли вигідніше модернізувати ПК, а не купувати нові?
- Як неправильно підібрана техніка збільшує витрати бізнесу.
- Які характеристики ПК реально потрібні для офісної роботи?
- Як налаштувати резервне копіювання без складної IT-інфраструктури.
- Що входить у сучасне IT-обслуговування: більше, ніж ремонт комп’ютерів.